把三份 K8s stack 合併成單一 Helm stack
起點與多份副本的維護問題
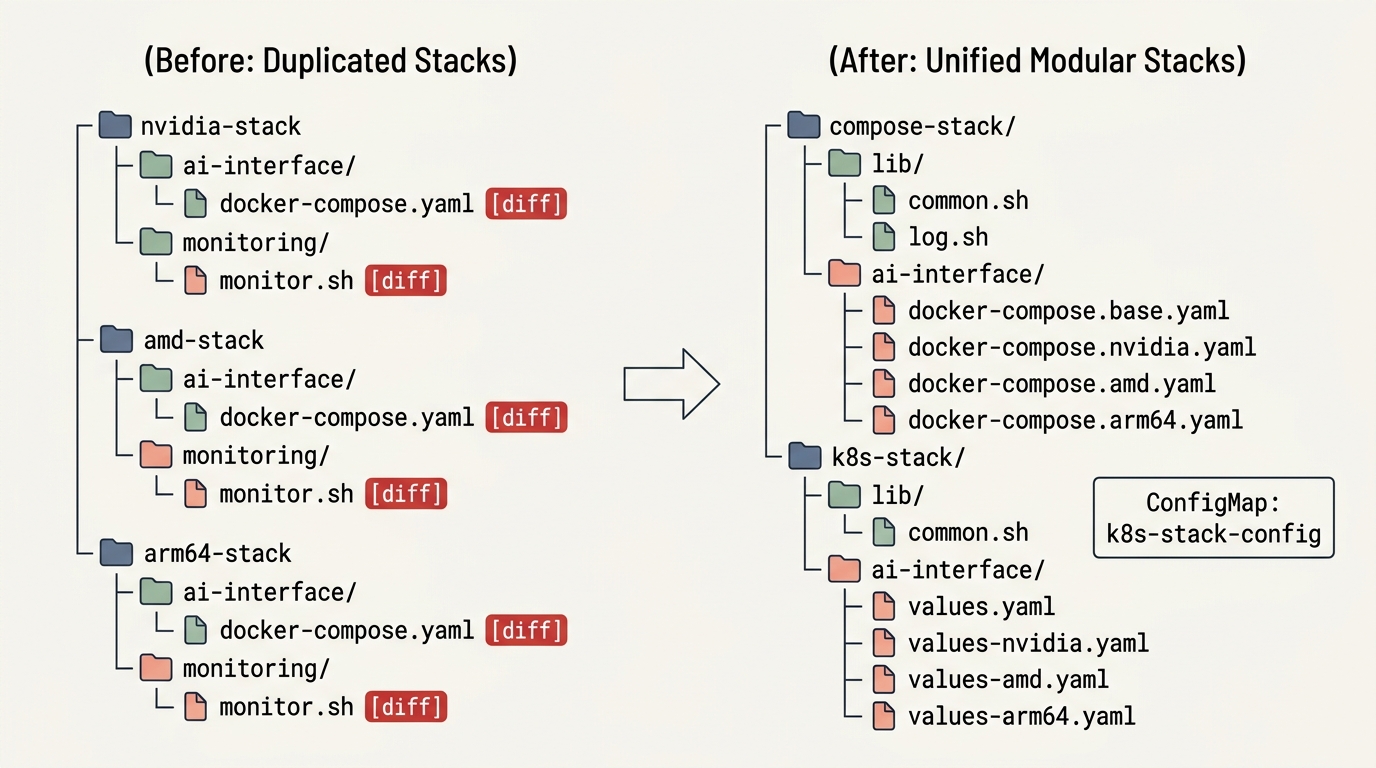
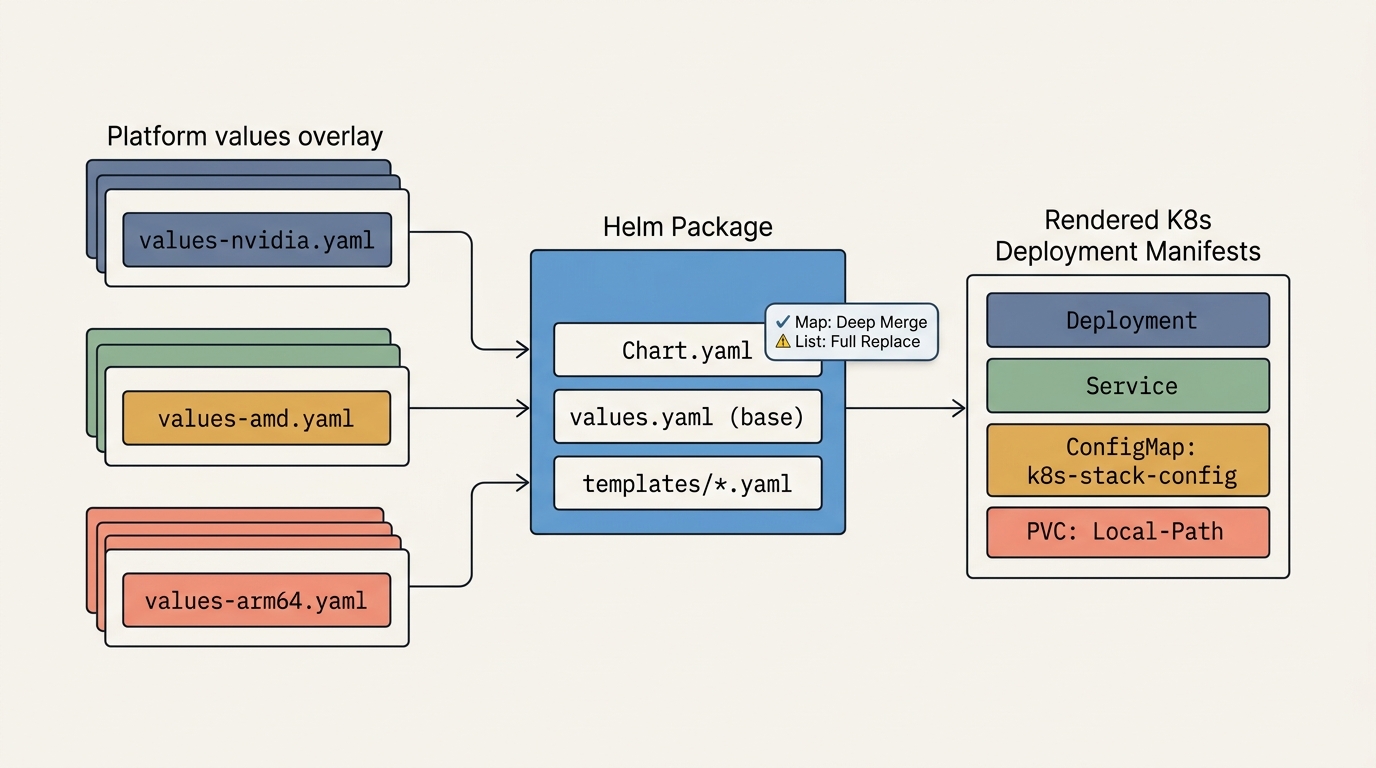
我們的 K8s 部署原本是三份平行的 stack:nvidia、amd、arm64 各一份。維護規則寫在 CLAUDE.md 裡,只有一句話: 改一份要同步三份。
這條規則的問題不在於它難懂,而在於它把一致性外包給人的紀律。實際的腐化程度可以量:舊的 master-deploy.sh 在三份副本之間有高達七成以上的內容完全分岔。這已經不是「三份副本」,而是三支不同的腳本共用同一個檔名。
$ git diff --stat deployments/k8s-nvidia/master-deploy.sh deployments/k8s-amd/master-deploy.sh
 master-deploy.sh | 197 +++++++++++++++++++++++++++++++++++--------------------
 1 file changed, 126 insertions(+), 71 deletions(-)
TOC
選用 Helm 而非 Kustomize 的考量
我們決定選 Helm 而不是 Kustomize,理由不是因為「Helm 比較潮」,而是因為 我們要覆寫的元件大部分根本不是自己寫的。
| 需求 | Kustomize | Helm |
|---|---|---|
| 覆寫開源上游 Chart(Postgres、pgAdmin、n8n、Open WebUI、GPU 相關等…) | 要先 render 成 YAML 再 patch,等於自己維護一份 fork | 原生就是 values-<platform>.yaml |
| 平台差異 | overlay 目錄,仍是「多份樹」的形狀 | 同一棵樹 + 一份 values |
| 條件式資源(SSO 開/關) | patch 刪資源很彆扭 | {{- if }} 直接不渲染 |
| 版本釘選 | 沒有這個概念 | --version 是一等公民 |
決定性的一點是第一列。這個 AI Stack 深度依賴了多個開源社群的上游 Chart(例如 Postgres、pgAdmin、n8n、Open WebUI 以及 GPU 相關元件 等…)。
如果採用 Kustomize,我們就必須先把這些官方 Chart 全部 template render 成純靜態 YAML 再來寫 Patch,這無異於自己維護一份龐大且難以跟隨官方更新的 Fork;而 Helm 則原生支援透過官方 Release 搭配一份簡潔的 values-<platform>.yaml 進行乾淨的宣告式覆寫。
Repo 至今沒有任何 kustomization.yaml,這是刻意的。
開工前的 Helm 語意實測
這是整個專案裡我最推薦別人照做的一步,也是最少人做的一步。
我和 AI 一起規劃這套架構時,AI 產出了一份詳細的架構計畫文件,但裡面特別寫了一行備註:
所有 Helm 語意 ⚠️ 全部是推測、零實測(規劃機器上
which helm找不到)。
AI 在規劃階段寫下的每一條 Helm 行為斷言,本質上都是憑著訓練權重記憶的「推測」。而這些斷言正要拿來當作 17 個 chart 的設計依據。如果盲信 AI 的架構假設直接動工,後面必然踩大坑。所以在動工前我們確立了首要原則: 先由我用容器完成實測記錄並納入文件,不要憑空推測。
實測是用容器跑的,不裝任何東西:
docker run --rm -v "$PWD:/w" -w /w alpine/helm:3.21.0 \
 template <release> ./chart -f values.yaml --kube-version v1.36.2
--kube-version 那一段不是裝飾。helm v3.21.0 離線預設的 KubeVersion 是 v1.35.0,而現場節點是 v1.36.2+k8s1(差一個 minor)。不指定的話,你驗的是另一個叢集。
實測發現的四個 Helm 行為特性
這一組結果應該裱起來,因為它們共同構成一個母題: helm template 回 0 不是任何東西的證據。
| 實驗 | 結果 | rc / stderr |
|---|---|---|
n8n overlay 覆蓋 extraEnv | base 25 筆 → 1 筆 | rc=0、stderr 0 位元組 |
| 餵一個完全虛構的頂層 values key | 渲染成功、設定完全沒生效 | rc=0、零警告 |
--set-string sso.enabled=false | 命中 1( 關不掉 );--set sso.enabled=false 命中 0(正確) | 兩者 rc=0 |
--set config.extraEnv[30].name=FOO(索引超出長度) | 渲染出 10 個 - null(每個 Deployment 5 個) | rc=0、stderr 0 B |
第二列值得展開。很多人以為 values.schema.json 或 chart 自己的 additionalProperties 會擋掉打錯的欄位名。實測 n8n 1.11.0 全檔有多處 additionalProperties, 沒有任何一處在頂層設 false。所以頂層打錯字 = 靜默無效。
第三列的判準常被寫成教條(「一律用 --set-string 比較安全」)。實際判準是 目標欄位的型別:字串 "false" 在 Go template 裡是 truthy,用 --set-string 去關一個布林開關,開關會關不掉,而且 helm 不會抱怨。
第四列則直接否定了「用 --set 追加一筆 list 元素」這個很多人以為可行的做法:--set list[N] 是 依索引就地覆寫,索引還會隨 values 疊加而漂移。
關鍵架構決策與取捨
1. 每個模組獨立 Chart 與 Release
好處是爆炸半徑小、可以單獨 rollback。代價是 跨模組的順序依賴變成 deploy.sh 的責任,Helm 幫不上忙。這個代價我們認了,因為模組之間本來就有 shell 層的 preflight。
2. 直接引用官方 Chart 不做 Dependency
理由是一條 Helm 的刪除語意: Helm 不會升級、也不會刪除 chart crds/ 目錄裡的 CRD。結果是 controller 換了新版、CRD 還停在舊版,新欄位被 API server 靜默丟棄,又是一個沒有任何地方看起來不對的失敗。
⚠️ 補充說明:這條通則 至今沒有實測。wiki 自己把它記為「結論已知、原始輸出未留存,需重測」。它是「不做 dependency」這個核心決策的唯一理由,卻是本輪唯一沒被驗證的斷言。
唯一有實測的相關案例是 gpu-operator:它用 pre-upgrade hook 繞過這個限制,代價是升級必須加 --disable-openapi-validation。
3. 刻意排除進 Chart 的元件
判準寫成一句話是「產生 K8s API 物件才進 chart」,但每一項排除的 真正理由都不同,這才是有價值的部分:
| 排除項 | 理由 |
|---|---|
| Namespace 建立 | helm uninstall 會把 ns 內 其他 15 個模組 一起刪光 |
| Secret 建立 | lookup 在 helm template 下回空 → 渲染出 空密碼 並覆蓋既有正確值 |
| 驗證與備份還原腳本 | restore 必須在 叢集半死 的時候還能用 |
第二列是最陰險的:lookup 在 install/upgrade 時能讀到叢集、在 template 時回空。你的 golden 驗證會看到空密碼,而正式部署會看到真密碼,兩邊都看似「正常」。
已知並接受的代價有兩個:
- 同一模組 兩種部署機制並存(chart + shell),rollback 不同步。
k8s-stack-config進了 chart,等於給整個 stack 加了單點: 7 個模組、8 個檔案、32 處configMapKeyRef,幾乎都沒有optional: true(唯一例外是CACHE_INDEX_PORTAL)。因此它掛了helm.sh/resource-policy: keep。
4. 保留 Release Name 避免改名衝突
release name 改名等於資源改名。 這個專案有前科,而且那次的修法是「要先 helm uninstall 舊 release 才裝得上」,當時的紀錄自己帶著 NOTE: requires helm uninstall cache-service first (else Helm ownership conflict)。
所以合併前先訂了一份保名清單,最終樹全數保住:open-webui、n8n、postgres、pgadmin、api-gateway 等。
同樣的風險在 cache chart 上又被防了一次: selector 在 K8s 是 immutable。selectorLabels 如果取 .Release.Name,改名那天 helm upgrade 會直接失敗。所以改成字面值(且渲染輸出不變)。注意 fullnameOverride 救不了這個:它只鎖 metadata.name,鎖不住 selector。
5. resource-policy keep 的套用準則
這是我覺得最值得留下來的判斷,因為它推翻了「加上去總比較安全」的直覺:
| 資源性質 | 要不要 helm.sh/resource-policy: keep |
|---|---|
資料類(PVC、k8s-stack-config) | 要加 |
| 設定開關類(SSO ConfigMap) | 絕對不加(關閉功能靠的就是 Helm 的刪除行為) |
而且 keep 只阻止 Helm。kubectl delete namespace 與 rm -rf 照樣刪光。這個誤解在專案裡被更正過兩次。
Helm List 合併覆蓋問題
Helm 的 values 合併規則只有一句話,但後果不成比例:
map 深合併,list 整份取代。
計畫把它點名為「本次最容易造成靜默行為變更」的一條。而它其實已經潛伏很久了。
1. Open WebUI 資料庫變數被覆蓋
原本的 SSO overlay 用自己的 extraEnvVars list 疊在主 values 上。list 整份取代的結果:主檔的 11 個 env 全部消失,包含 DATABASE_URL。
這條路徑之所以從來沒有炸過,只有一個原因:三份 bootstrap 的 SSO_ENABLED 都是 "false"。 功能從來沒有被開啟過。 而如果哪天有人打開它,pod 會照常 Running、health check 會照常綠,DATABASE_URL 不見的 Open WebUI 會 fallback 到 SQLite 容器內暫存,導致重開機資料消失。
修法是改走 chart 16.0.0 的原生 sso.* map。map 深合併,碰不到 extraEnvVars。驗證結果: 零消失,只新增 6 個 OIDC 變數。
2. n8n 缺乏原生欄位的處理方式
n8n 上游 chart 沒有原生 SSO 欄位。實測 n8n 1.11.0:sso / extraObjects / extraDeploy / extraManifests / extraResources 全部零命中。
於是走另一條路:自有 chart 出一份 ConfigMap,base values 一次寫死 configMapKeyRef 並加 optional: true。開關由 ConfigMap 存不存在決定。
同一個專案、兩個服務、兩條不同的路,這不是疏漏,而是同一棵判斷樹落到不同分支:
上游 chart 有原生欄位?
├─ 有 → 用原生欄位(map 深合併,安全) → Open WebUI
└─ 沒有 → 有 extraObjects/extraDeploy 之類的逃生口?
 ├─ 有 → 用它
 └─ 沒有 → 自有 chart 出 ConfigMap
 + base values 寫死 configMapKeyRef + optional: true → n8n
3. ConfigMap 更新不會觸發 Rollout
有一批設定反而 從 ConfigMap 搬回 chart(例如 7 個 OLLAMA_* 參數改為 chart 的 envPlain)。
理由是 configMapKeyRef 存的是指標:ConfigMap 的值改了,而 pod spec 一字未變 → 不會觸發 rollout → 容器繼續跑舊值,而 kubectl get cm 卻顯示新值。
具體後果是有紀錄的:當初把 OLLAMA_NUM_PARALLEL 或上下文視窗參數改為 32768 那一次,在既有叢集上需要手動 rollout restart 才真正生效。
實際落地與 AI 規劃的落差
這一節是全篇最有價值的部分,所以不美化。當初 AI 產出的那份計畫,自我評語是「方向正確,地基不穩」;事後看,這句話完全命中。AI 能給出工整漂亮的架構藍圖,但它看不到真實生產環境的泥濘。
1. Chart 目錄結構調整
AI 最初擬定的目標結構是集中式的 k8s-stack/charts/<module>/,並言之鑿鑿地把 「模組目錄下不得出現 charts/ 子目錄」 列為三條不可協商的規約之一。
但實際動手落地時,我們發現集中式結構會把服務定義與 Chart 嚴重割裂,最終我們轉向為 <module>/chart/,決定「讓 chart 回到它所屬的服務目錄下」:多服務模組採用 <模組>/<服務>/chart/,單一服務則用 <模組>/chart/。這與 AI 當初想像的方向完全相反。
而且改得不夠早。observability 與 portal-service 是先前已經完成的模組,事後才回頭拆成六個與兩個 chart。AI 在計畫裡其實早就預警過這件事:「定案前搬第一個模組,第二輪就收不回來。」預警了,但我們還是撞上了。
2. 原定規約與實務衝突
| AI 原本規約 | 實際 |
|---|---|
| 三份平台 values 一律存在,零差異者放空殼 → 薄殼 無條件疊加、缺檔即大聲失敗 | 只有 5 / 17 個 chart 三份齊全;deploy.sh 改成 if [ -f ] 條件疊加,缺了靠 chart 內的 required 哨兵擋 |
每個 chart 都要有 values.schema.json | 0 份 |
k8s-stack-lib library chart + k8s_ai_stack_helm 薄殼 | 兩樣都沒出現在最終樹(lib/ 是 shell 函式庫,不是 library chart) |
三份齊全的只有 bootstrap、core-engine、parser-service、vector-db、llm-gateway;ai-core 與 node-exporter 只有 values-amd.yaml;其餘 10 個只有 values.yaml。
3. 驗證工具維護成本考量
AI 在計畫裡花了很大篇幅規劃自動化驗證工具 docs/verify-k8s-render.sh。
但這套共用驗證工具 最後沒有真正留下來。在推進過程中我意識到:AI 傾向於設計包山包海的自動化工具,但維護這套驗證腳本的成本比重構本身還高。與其花大量時間維護一套龐大的測試框架,不如確立「以 Git commit SHA 作為不可變 baseline」,並在每次重構後對輸出做一次性嚴格比對。
實務上發生的事情是: 驗證有做,共用工具沒有。 每個 Helm 化步驟各自做了一次性的渲染比對,而且做得很紮實:
- observability 三平台 23 / 21 / 23 documents 逐字相同
- portal-service 十個 documents IDENTICAL
- GPU values 搬位置後 18 份渲染零差異、9 條告警規則 uid 逐字未變
- ai-core 的 AMD 渲染與基準比對 零差異(完全一致)
所以合併沒有改變行為這件事是有證據的。但下一個人要重跑這些驗證,得自己重寫工具。
4. 備份還原機制缺失與修復
整套 Helm 化原本建立在一個 AI 提出的樂觀假設之上(「叢集現場資料隨時可重建」),所以可以大膽拆掉重裝。
但事前根本沒有人真正驗證過「拆掉重裝」到底走不走得通。 當我真正動手在測試環境實測時,立刻抓出四個致命的地基缺陷,如果完全照 AI 的預設直接拆掉重裝, 必然發生不可挽回的資料災難:
- 備份漏了六個 DB
- restore 因為 PV UID 變了, 必然還原成空
- Keycloak realm 設定從未 export
- n8n 的靜態 PV 會卡死重建
AI 的這個出發點看似合理,但前提是「備份與還原必須百分之百可靠」。這就是為什麼在前期階段我們把全部心力花在驗證與修復備份,一行 chart 都還沒動。
備份腳本失效的根因
備份腳本 20 天來每天準時跑、吃掉 60 GB,裡面一個資料庫都沒有。 單次備份目錄的內容是:3.0 GB 的 pvc-data.tar.gz、 兩個 0 bytes 的 YAML、 0 個 .sql.gz。
根因鏈值得完整寫出來:
cron 的 KUBECONFIG=/root/.kube/config 指向一個會回 HTML 的壞檔
 → kubectl: invalid character '<'
 → shell 重導向「先建檔、kubectl 才失敗」→ 留下 0 bytes 的 YAML
 → 腳本沒有停,照樣往下跑到成功結尾
而 沒有人發現,因為 restore 從來沒有成功跑過任何一次:函式外用了 local,在 set -eo pipefail 下 rc=1 當場死。一句話總結: 沒有人成功還原過,而沒有人還原過是因為根本沒有東西可還原。
更好笑的是:唯一有被備份的那個 DB,正好是規則上 明訂不給任何應用程式用 的 k8s-stack(db-operator 的 bootstrap DB)。包括 n8n、open-webui、keycloak、pgadmin 等應用資料庫全數漏掉!
為什麼健檢沒抓到?因為健檢用 pg_isready -U adm( 不做認證 ),而 pg_dump -U adm 一直被 db-operator 的 peer 認證擋掉(db-operator 的 pg_hba.conf 固定配置為 local all all peer 而且無法從外部 values 覆寫)。 健檢全 PASS,而備份是壞的。
連鎖錯誤與修復過程
修好 KUBECONFIG 的那一刻,備份與還原會從「靜默空轉」變成「直接失敗」;底下還埋著兩顆尾綴 && 地雷,在 健康 叢集上必定觸發:
# find_pg_pod 裡的寫法:第一個 selector 成功時,這一行整體回傳 1
[ -z "$PG_POD" ] && kubectl get pod -l <另一組 selector> ...
# set -e 當場砍掉整支腳本
這顆是 造 kubectl stub 實跑才發現的,讀碼看不出來。
由此得到一個可以帶走的觀點: 靜默失敗會互相掩護。 修掉外層那個之前,內層地雷連引爆的機會都沒有;所以「修好一個 bug 之後東西壞得更明顯」是正常的,不是你改壞了。
還原路徑本身也必然對不上,而且是 會印 ✅ 成功 的那一種失敗:local-path 的目錄名內含 PV UID(同專案的 reinstall-all.sh 就在 glob pvc-*_k8s-stack_*),重建後全是新 UID。修法是備份 key 只用 <ns>_<pvc>,解析不到就 ERROR 中止、不再印假成功。
端到端演練與驗收
在正式切換前,我們在節點上真的跑了一次完整的備份 → teardown → 清孤兒 → 重建 → 還原 → 驗收:
| 驗收項 | 結果 |
|---|---|
| 六個應用 DB 比對 | 完全一致(僅有的少數差異為服務啟動後自寫的記帳資料) |
| 向量資料庫 point | 234 個 point 全數回來(唯一無法從全新安裝重建的資料) |
| Secret | 23 個 key sha1 逐一相同(含 WORKFLOW_ENCRYPTION_KEY) |
| 健檢 | 21 PASS / 0 FAIL / 2 SKIP,與演練前逐字相同 |
備份輪替也順手訂了預設:30 天備份組 / 7 天全量 / 3 天失敗組。30 天全量估約 150 GB(區間 90–390),預設組合約 42 GB。
「現場隨時可重建」這句話,直到我們親手修好備份、跑完一輪完整還原演練後,才真正有了底氣。
5. 現有叢集資源收編與平滑遷移
Helm 化之後有個極其現實的問題:既有節點上的資源原本是用 kubectl apply 建的, 沒有 Helm 的 ownership metadata,helm upgrade 會直接報錯拒絕。
AI 當初在計畫裡樂觀地斷言「現場隨時可重建,因此不需要寫平滑遷移 SOP」。但當實測發現直接重建風險太高後,我決定老老實實整理出詳細的 MIGRATION.md 遷移指南,並搭配一支只讀不寫的檢查腳本 helm-ownership-check.sh:
本文只處理 一件事:舊資源的 Helm 所有權(ownership metadata)
它的做法非常克制: 只讀不寫:
- 列出待收編的資源,並把
kubectl annotate/kubectl label指令 印出來讓你自己貼,絕不代動活叢集。 --install救不了 ownership 衝突:它解決的是「release 不存在」,現場撞到的是「資源存在但不屬於任何 release」。所以deploy.sh刻意不自動收編,只攔截錯誤碼並印出引導。- 結論是 全部就地收編、沒有任何資源需要刪除重建。TODO.md 原本寫反了,並自我更正:「本節原本寫著『正解是走完整重建』,那是錯的」(照做會刪掉
k8s-stack-secrets,n8n 的加解密金鑰遺失會導致所有 Workflow 永久損毀)。
6. 其他架構調整與收穫
- Pilot 模組不見了:AI 最初在計畫中指定 custom-gateway 當 Pilot,最後它不是被 Helm 化,是被整個移除(原本要整合進 portal-service,整合還沒做)。
- 收尾模組(Cleanup/Bootstrap)的收益兌現了:Helm 化消滅了一個不可逆且吞錯的
kubectl patch svc --remove /spec/selector,以及「manifest 說replicas: 0、腳本說 scale 1」的兩份真相。 - 釘版帶來 2 處行為變更:pgAdmin 升級(template 相同)、n8n 升級至 1.11.0(readiness probe 改為
/healthz/readiness)。
重構心得
隱蔽性故障的警示
n8n 那套「ConfigMap + optional: true」的設計有一個 fallback 值剛好是 合法值 的問題:
一次 kubectl 抖動
 → 降級回 false
 → helm 刪掉 SSO ConfigMap
 → kubelet 因 optional:true 靜默跳過五條變數
 → SSO 被關掉
全程 rc=0、pod 正常 Running。 沒有任何一層會覺得不對。
依據情境判斷而非盲從規則
這次留下來最耐用的東西,都不是規則,是判斷:
resource-policy: keep對資料類要加、對設定開關類絕不加,因為關閉功能靠的就是刪除行為。--setvs--set-string的判準是 目標欄位的型別,不是「統一用哪個比較安全」。--soft載入的分級依「 值錯了會怎樣」,不是依模組。
規則會被套用到不該套用的地方;判斷不會。
暴露潛在問題是重構的最大價值
Helm 化本身沒有想像中難。難的是它逼你面對一份清單: 你以為在跑的東西其實沒在跑:
- time-slicing 是死碼
- alert 規則的 CRD 從未安裝
- restore 從未成功過
- 備份跑了 20 天,一個 DB 都沒有
這份清單上的每一項,都是在「為了做 Helm 化而必須先確認現況」的過程中掉出來的。如果不做這次合併,它們可以再安靜地待很多年。
實務驗證是重構成功的關鍵
其餘是搬移與修 bug。計畫自己也承認:「階段 7 才是真正的重構,1–6 都是搬移與修 bug。」
所以如果你要跟 AI 一起做大型架構重構,時間分配大概是這樣的: 大部分力氣必須由工程師親自花在確認地基與實測驗證,而不是放任 AI 狂寫 chart。AI 寫的架構計畫裡,charts/ 的目錄結構洋洋灑灑列了三條不可協商的規約,備份能不能還原則只有一行帶過。
事後回看: AI 給的三條規約在現實中全部被推翻,真正保命的,只有工程師親手踩坑、修好備份的那一步。